Réponse rapide : MemoMind One vous entend clairement grâce à trois microphones et à MemoMind Audio AI, son système acoustique développé en interne, qui combine formation de faisceau par IA, annulation de l’écho et du bruit, et réduction du bruit du vent, en plus de la détection du mot d’activation et de la reconnaissance vocale.
Dans notre dernier article technologique, nous avons examiné la façon dont MemoMind One contrôle les fuites sonores — c’est-à-dire jusqu’où vous et les personnes autour de vous pouvez entendre MemoMind One. Cet article répond à la question inverse : comment MemoMind One vous entend-il clairement dans le bruit ?
Capture de votre voix : réseau de microphones intégré à MemoMind One
Vous dites « Salut, Memo » sur le quai animé d’une gare. Pour vous, ce ne sont que quelques mots. Pour les microphones de la MemoMind One, tout arrive en même temps : votre voix, les annonces, les conversations à proximité, les bruits de pas. Avant de pouvoir vous entendre clairement, MemoMind One doit d’abord tout capturer.
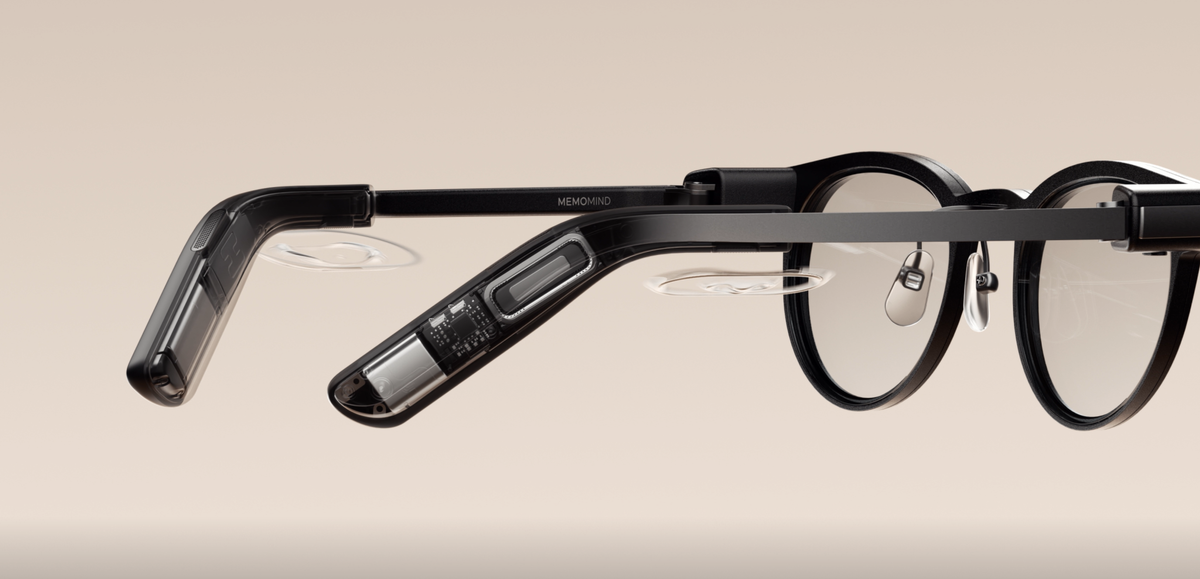
Grâce à trois microphones haute sensibilité intégrés à ses branches en titane, MemoMind One forme un réseau de microphones qui capte le son depuis différentes positions. Alors qu’un seul microphone n’entend qu’une seule version d’un son, trois microphones captent des versions légèrement différentes de ce même son. L’IA audio de MemoMind One traite ensuite ces informations afin de filtrer et de ne conserver que le son spécifique que vous souhaitez que l’appareil entende.
Écoute de votre voix : les lunettes audio intelligentes captent votre voix
MemoMind Audio AI, le système acoustique intelligent développé en interne par MemoMind et fonctionnant en périphérie, analyse l’environnement sonore en temps réel afin d’extraire précisément la voix du porteur.

Étape 1 : repérer votre voix
La formation de faisceau par IA exploite les infimes différences de temps entre plusieurs microphones pour concentrer l’attention du système dans la direction où vous parlez, ce qui permet de mieux isoler votre voix.
Le faisceau s’adapte à votre activité : en mode Réunion, il s’élargit pour capter des voix lointaines jusqu’à environ 5 mètres ; en mode Traduction, il se resserre sur la personne qui parle directement devant vous ; en mode Conversation IA, il se concentre sur la voix du porteur.
Étape 2 : éliminer le bruit
Une fois que le système sait où écouter, il doit tout de même traiter le reste.
L’annulation du bruit environnemental (ENC) aide à réduire les sons parasites tels que les bavardages, les voix à proximité et les bourdonnements constants pendant les appels. La réduction du bruit ambiant (ANR) traite les bruits environnementaux plus larges dans les situations quotidiennes, tandis que la réduction du bruit du vent aide à atténuer les turbulences à basse fréquence créées lorsque le vent frappe les microphones.
Il existe une autre source potentielle d’interférence : les lunettes elles-mêmes. Lorsque le son émis par les haut-parleurs est à nouveau capté par les microphones, l’annulation de l’écho acoustique (AEC) aide à éliminer ce retour et à l’empêcher de se transformer en écho.
Étape 3 : préserver la clarté de votre voix
Le volume de votre voix n’est pas toujours exactement le même. Vous pouvez parler doucement lors d’une réunion et hausser la voix à l’extérieur.
Le contrôle automatique du gain (AGC) ajuste automatiquement le niveau de la voix captée pour rendre votre élocution plus uniforme. Parallèlement, l’optimisation audio multi-scènes adapte le traitement de la voix aux différents environnements, aidant à équilibrer le volume et la clarté de la voix, que vous soyez à l’intérieur ou à l’extérieur.
Il s’agit de la partie d’entrée du système acoustique de MemoMind — entendre votre voix avec précision avant tout traitement. Associé à la partie de sortie, votre voix entre clairement et MemoMind One minimise les fuites sonores vers les personnes autour de vous.
Vous comprendre : de la reconnaissance vocale à la réponse de l’IA
Dans une gare bruyante, capturer votre voix n’est que la première étape pour le système de traitement audio de la MemoMind One ; ce qui compte vraiment, c’est la capacité de l’IA audio à vous comprendre avec précision :

Étape 1 : se réveiller
MemoMind One écoute en permanence à faible puissance le mot d’activation « Salut, Memo ». La détection du mot d’activation intégrée à l’appareil active l’intégralité de la chaîne vocale uniquement lorsque vous l’appelez, sans diffuser en continu de l’audio brut vers un autre service.
Étape 2 : détecter la parole
Une fois activé, la détection d’activité vocale par IA (VAD) aide le système à distinguer la parole des sons du quotidien tels qu’une toux, une porte qui se ferme ou de la musique en arrière-plan. Cela évite que des sons sans rapport ne soient pris pour de la parole et réduit les traitements inutiles.
Étape 3 : séparer les voix
Lors d’une réunion, dans un café ou tout autre environnement animé, plusieurs personnes peuvent parler en même temps. La séparation des locuteurs aide à distinguer votre voix des conversations à proximité, offrant à l’IA un signal plus net sur lequel travailler.
Étape 4 : répondre rapidement
Comprendre vos paroles n’est que la moitié de l’expérience. Une chaîne vocale à faible latence maintient chaque étape du traitement étroitement connectée, réduisant le délai entre le moment où vous terminez de parler et celui où l’assistant répond — l’interaction paraît ainsi plus naturelle.
En optimisant en permanence la qualité du prétraitement de la parole, elle améliore la précision de compréhension de l’ASR et des modèles d’IA, permettant aux lunettes à écran MemoMind One de maintenir une interaction humain-machine stable et naturelle, même dans des environnements complexes — inutile de vous répéter encore et encore.
Vous reconnaître : confidentialité de l’empreinte vocale dans les lunettes audio MemoMind
Aujourd’hui, MemoMind Audio AI se concentre sur un seul objectif : aider les lunettes à vous entendre plus précisément. La prochaine couche que nous développons va encore plus loin — non seulement entendre clairement une voix, mais reconnaître à qui elle appartient :
-
La reconnaissance de l’empreinte vocale — identifie le porteur grâce à ses caractéristiques vocales uniques, un peu comme une empreinte digitale identifie une personne. Dans le module de confidentialité de l’application MemoMind, une fois votre empreinte vocale enregistrée, vos souhaits, vos tâches, les enregistrements de réunions et vos entrées mémorielles ne vous sont attribués que lorsque l’empreinte vocale correspond — ainsi, si une personne à vos côtés dit « Je veux un Switch », cela ne sera pas enregistré comme votre souhait. Et dans les enregistrements de réunions, tout ce que vous dites est marqué « Moi ».
-
La confirmation de l’identité de l’utilisateur — garantit que l’assistant répond bien à son véritable porteur, et non à une conversation ambiante à proximité.
L’avenir des lunettes IA sans caméra MemoMind réside dans l’amélioration continue de l’expérience audio, faisant de la voix un moyen plus naturel et intuitif pour les personnes d’interagir avec l’IA.
FAQ
MemoMind One peut-il m’entendre clairement ?
Oui, MemoMind Audio AI est conçu pour vous entendre clairement. Il s’agit d’un système acoustique intelligent qui utilise l’IA pour gérer l’intégralité de la chaîne de traitement audio, garantissant ainsi une interaction vocale dans des environnements allant des bureaux et cafés aux espaces extérieurs.
Ma voix est-elle traitée sur l’appareil ou dans le cloud ?
MemoMind One effectue certaines étapes clés de son traitement audio sur l’appareil, notamment une partie de l’isolation vocale directionnelle, ce qui aide à réduire la latence avant que l’audio ne soit transmis aux services en aval. Toutefois, des fonctionnalités telles que le traitement des transcriptions, l’assistance par IA et la mémoire peuvent impliquer des services connectés et un traitement dans le cloud, selon la fonctionnalité et l’état de la connexion.
Comment MemoMind One peut-il fonctionner sans caméra ?
MemoMind One adopte une approche de l’interaction par IA axée sur l’audio. Son réseau de microphones capte la parole et les sons ambiants, tandis que le traitement audio alimenté par l’IA aide à identifier et à prioriser les sons pertinents. Cela vous permet d’interagir naturellement avec l’assistant grâce à votre voix tout en conservant des lunettes sans caméra.